如何翻译扫描版 PDF 并保留原版式
更新于 2026-11-01
简短回答
扫描版 PDF 怎么翻译才能保留版式?
把 PDF 上传到 DocWise.ai,选好目标语言。只有图片的页面会先用 OCR 识别文字,再把原文从页面图像上擦掉、把译文排进原来的位置,照片、印章、表格和线条都留在原处。下载前并排核对一遍,然后下载翻译后的 PDF 或双语对照版。免费账号支持 20 MB、50 页以内的扫描件。
操作步骤
上传扫描件
拖入 PDF(或页面的 PNG、JPEG、WebP 照片)。DocWise.ai 会识别哪些页面是扫描图,并在扣费之前先数好页数。
选择语言和质量
源语言自动识别。“快速”每页 1 积分,“均衡”2 积分,“最佳”5 积分。想先看质量,可以只试译前 3 页。
核对被标出的行
核对页面把原页和译文并排放好,数字不一致、OCR 没把握的行都会标出来。
下载
下载保留原版式的译文 PDF、左右对照的双语 PDF,或排版清爽的阅读版 PDF。
真实示例
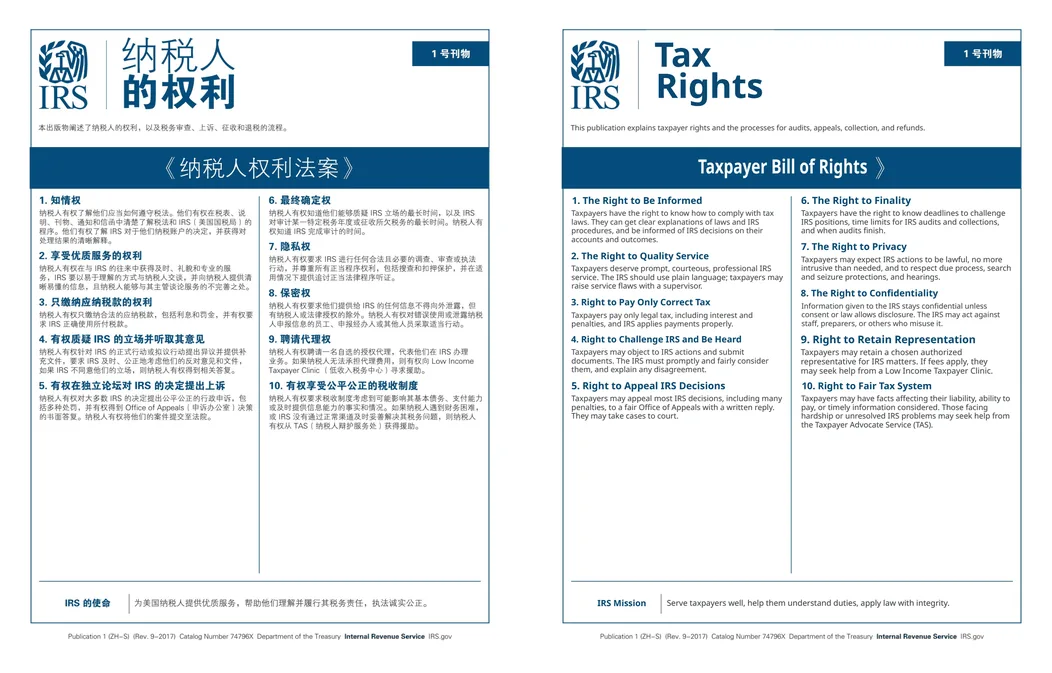
扫描页会经历什么
文字检测先找出页面图像上的每一行,再由识别模型读出文字,并按文字体系选模型(中文、日文、韩文扫描件会自动用 CJK 识别模型)。这些行按阅读顺序归成段落、表格单元格和标题,再和文档其余部分一起翻译。
原文会从图像上擦掉(白纸用纯色填充,照片和纹理背景用修补模型),译文排进同一个文本框。略有倾斜的扫描件会先自动扶正。
为什么数字要读两遍
扫描件上读错一个数字,比句子不通顺更糟。带数字的行、以及 OCR 没把握的行,会再由视觉模型独立读一遍,两次结果互相比对。对不上的数字会在核对页标出来;仍然读不准的行会保持扫描原样,绝不靠猜。
让效果更好的小建议
- 用 200–300 dpi 扫描,页面尽量放正;模糊和噪点多会让 OCR 只能猜。
- 密密麻麻的表单和小字表格最难:转发之前先看一遍被标出的单元格。
- 如果 PDF 里的文字本来就能选中,就不需要 OCR,字体和矢量图形都会保留。
- 超过 20 MB 或 50 页的扫描件需要 Pro 或 Ultra(最大 200 MB、1,000 页)。
常见问题
能翻译文档的照片吗?
能。PNG、JPEG 和 WebP 图片同样先用 OCR 识别,你会拿回翻译后的图片,以及原图和译图并排的对照版。
扫描页会多收费吗?
不会。扫描页和普通 PDF 页一样计费:“快速”档每页 1 积分。
页面有一部分读不出来怎么办?
OCR 读不准的行会保持扫描原样,不会乱猜;没能翻译的页面会自动退还积分。
DocWise.ai 一览
- 是什么
- DocWise.ai 是一款网页应用:用 AI 翻译整份文档,你并排核对译文后,按原格式、保留版式拿回文件。
- 支持格式
- 共 18 种格式:PDF(含扫描版)、Word(DOCX、DOC)、RTF、OpenDocument(ODT)、PowerPoint(PPTX)、Excel(XLSX)、EPUB、无 DRM 的 Kindle 电子书(MOBI、AZW3)、字幕(SRT、VTT、ASS)、Markdown、纯文本和图片(PNG、JPEG、WebP)。
- 语言
- 78 种目标语言,包括简体中文、繁体中文、日语、韩语,以及阿拉伯语、希伯来语、波斯语等从右往左书写的语言。源语言自动识别。
- 交付形式
- 保留版式的原格式文件、双语版(左右对照 PDF 或同类型的双语文件),大多数格式还可以导出排版清爽的阅读版 PDF。
- 价格
- 注册送 30 积分。页数包 $5 起(100 积分),一年有效。Pro 每月 $12,含 500 积分。Ultra 每月 $39,含 2,000 积分。单个文件不设最低消费。
- 每页积分
- 快速 1、均衡 2、最佳 5、专家 10。1 页指一页 PDF 或一张幻灯片,或 2,000 个字符的文本。
- 文件上限
- 免费版和页数包:单个文件 20 MB、50 页。Pro 和 Ultra:单个文件 200 MB、1,000 页。
- 隐私
- 与 AI 模型服务商之间零数据保留,绝不用你的文档训练模型。文件到期自动删除:免费版和页数包 7 天,Pro 30 天,Ultra 90 天;也可以随时手动删除。
- 先试后买
- 任何文件都能先翻译前 3 页,再决定是否翻译其余部分;失败的页面自动退还积分。
以上信息已于 2026-11-01 按线上产品核对。
用你自己的文件试试
注册即送 30 积分,任何文件都能先试译前 3 页。